虽然CPU可以被认为是对传统技术的_致敬_,但让我告诉你,GPU则是_正式_的下一代。

超级马里奥 3D 世界 (2013).

塞尔达无双 (2014).

皮克敏3 (2013).

喷射战士 (2015).

塞尔达传说: 风之杖 (2016). 以极高的1920x1080像素进行渲染!
图形处理器位于Espresso旁边的一个大型硅芯片中,它叫做 Latte, 以 550MHz 运行,长话短说,它是广泛和复杂的。 Latte 拥有除图形处理外的更多基础功能,不要担心,这会在将在本文的下一节中进行解释。 现在,只需要记住图形处理位于Latte中。

又一张 SoC 的照片. 所以您在了解 Latte 之后就可以来思考这些了.
顺便说一下,对于意大利读者来说,你可能知道,Wii U的代号是由与咖啡有关的术语组成的,'Latte'也不例外,因为这是非意大利人所说的'Latte macchiato':' )
面临新挑战的旧伙伴关系
与任天堂和IBM的良好关系类似,这家公司也保持着一种独特的合作关系,他们从Nintendo 64开始.
ArtX是以设计Reality Coprocessor (当时是Silicon Graphics的一部分) 而闻名的团队,该团队后来研发了Flipper,GameCube的独特SoC,内置了其标志性图形处理器。 几年后,在被 "ATI"收购后,他们为Wii提供了Hollywood,从中我们发现了Flipper的GPU的加速版本. 但最重要的是,大约在同一时间,ATI一直在为微软研发一项尖端技术。 结果是 Xenos 及其面向大众的新着色器模型.
在Xbox 360发布多年后,ATI被一家名为 "AMD"的芯片公司收购,这使得我们要解释一下AMD的历史。
泰坦降临
AMD最初被称为英特尔的伙伴,曾经是英特尔 CPU(即 8086 和 80286)的第二个供应商,这种关系在 AMD 开始销售未经授权和改进的80386 CPU后破裂 。 英特尔对此十分不开心,很快,两家公司就成为了正面竞争者。
竞争如此激烈,以至于在上世纪90年代末,英特尔(Intel) 计划用他们的新系列"Itanium"cpu来占领64位市场,但很快就被AMD的更简单的替代方案挫败了: x86扩展"amd64"(也被称为"x86-64"). 因此,英特尔被迫采用AMD的标准。 作为参考,amd64仍然作为当前x86 CPU的ISA (截至2022年)。
然而,AMD从来都不是一帆风顺的。 由于与英特尔竞争的压力也带来了一些失败(即被放弃的"3DNow!"扩展,Fusion 的推迟发布等),现在,随着 2006 年收购 ATI,AMD 发现自己面临两条战线: 英特尔在 CPU 市场,英伟达在显卡市场。
下一代Radeon
我们已经分析了AMD,再让我们分析一下ATI的Radeon产品线状况。
在Xenos及其基于"统一渲染架构"的新架构推出后,ATI仍然忙于微软的项目,因此他们无法分配足够的资源在短期内将Xenos推向PC市场。 因此,剩下的团队专注于维护他们经典的x1000/R500系列,这为英伟达在ATI之前发布他们名为GeForce 8(具有Tesla架构) 的显卡留下了足够的空间。 最后,在 2007 年(Xenos 两年后) ,ATI 推出了 Radeon 2000 系列(代号为 R600) 和 它的 TeraScale 架构。 新设计现在不受微软的预算和许可控制,为那些愿意支付高价的用户带来了Xenos的所有优点,以及可选的额外功能。
现在,对于 Wii U,ATI 为任天堂准备了一张基于 Terascale 的显卡,但从未正式确认他们基于哪种型号。 Fail0verflow 将它与 Radeon HD 4000 系列 (代号 R700) 联系起来。 作为参考,基于R700的显卡于2008年推出,是R670和R600系列的增量更新。 最明显的变化是包含了更快的视频解码硬件和对OpenCL的支持,尽管只有前者(在某种程度上) 可以在Wii U上使用。
无论如何,Wii U的GPU有两个名字, 任天堂在提及硬件时称其为 GPU7,在提及 API 时称其为 GX2。 对于这篇文章,我将使用'GPU7'这个称呼,因为我将把重点放在硬件上。
GPU7的架构
TeraScale架构是Xenos/Crayola移植到PC 市场的具体化......而GPU7则是将TeraScale重新带回到主机. 它最明显的特征是使用统一着色器模型,将顶点和像素单元集中到一个单元中, 现在称为 SIMD 单元。
值得强调的是,虽然采用了Xenos,但是API模型仍然是基于segregated shader model(被隔离的着色器渲染模型),这样的话Xenos的库并没有提供更多的功能,导致现在仍然使用一个统一的计算单位。 好吧,多亏了后续更新(Direct3D 10 和 OpenGL 3.3),情况已不再如此。 回到Wii U,GX2是唯一可用的API,它是基于OpenGL 3.3。
硬件组织
大部分与图形有关的数据都存储在上述2GB的DDR3 RAM中,被称为MEM2,它由CPU和GPU共享。 这意味着GPU必须把数据存放在那里,但是MEM2相对较慢,并且没有为CPU和GPU并发工作所导致的竞争做优化。 因此,任天堂设计了与Xbox 360类似的东西,那就是加入了一个专用的、接近32MB的EDRAM(称为MEM1),用于快速操作(即渲染目标和其他高要求的缓冲区). 因此,不仅可以渲染更大的帧,而且还有额外的空间来执行具有可接受性能的后处理 (即抗锯齿)。
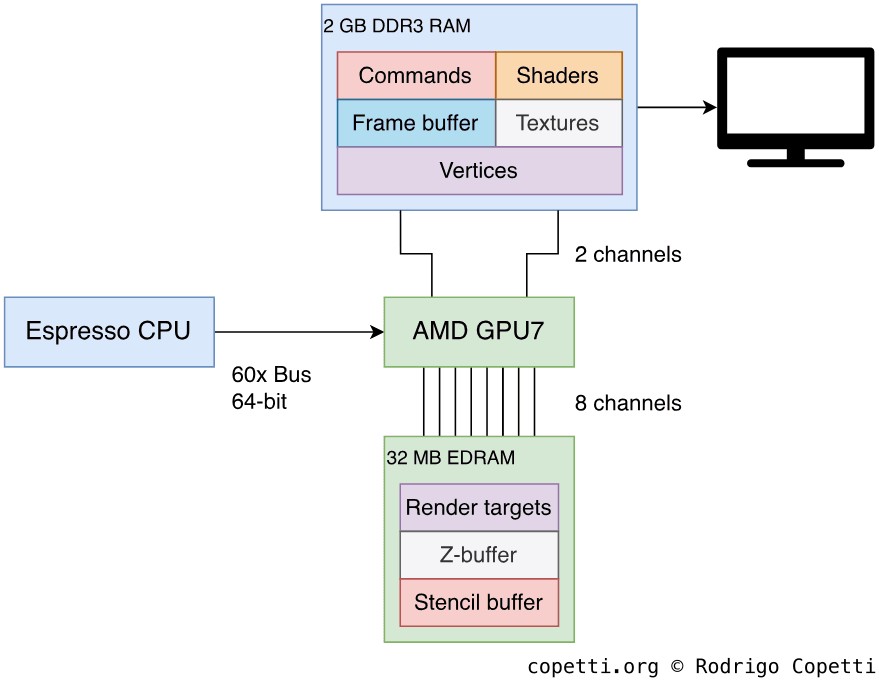
数据如何在可用内存中进行编排的例子.
反过来,Wii U的EDRAM 大于Xbox 360(意味着 tiling(tiling指的是一种将渲染区分割为小单元的技术,同样的可以在DC的图形板块看见)的需求更小了)。 然而,EDRAM不包括用于后处理的专用电路。
构造画面(frame)
这是《游戏机架构》系列的标志性部分,我试图解释将几何图形 (来自 CPU) 转换为像素 (用户最终在电视上看到的像素) 的过程。 然而,在这篇文章中,解释将有点不同,因为TeraScale的基本原理已经在Xbox 360的文章中解释过了。
自Xenos以来最重要的变化是几何着色器和计算着色器的实现(或者更好地说,标准化),两者都利用了统一渲染架构的新功能。 这并不意味着GPU7为了使用这两种新技术而被重新设计,事实上这只是在不修改硬件的情况下扩展了API来开启新的应用
作为一款为任天堂游戏机构建的AMD/ATI芯片,GX2支持两个着色器api, OpenGL's GLSL 3.3和OpenGL ESSL。 SDK还带有一些扩展功能,提供只有在GPU7上才有的功能,但它不支持OpenCL,当然也不支持Direct3D。
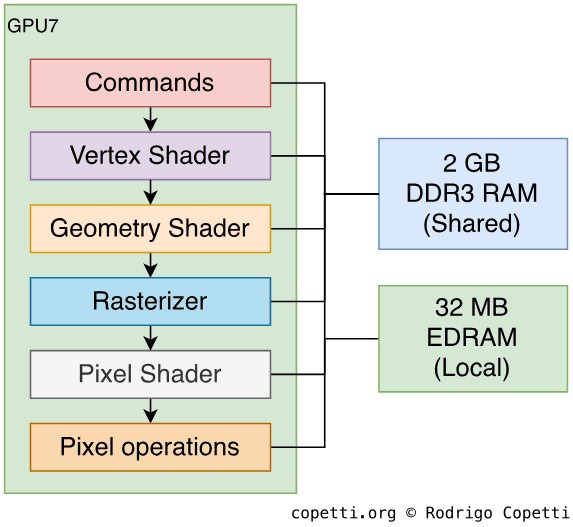
GPU7 的图形管道概览.
尽管如此,GPU7还是继承了Radeon R700系列的设计,所以GPU7的管线(pipeline) 在一定程度上与Direct3D 10.1和OpenGL 3.3标准保持一致。 虽然,他们各自的着色器语言并不为GPU7所理解 (他们需要随官方SDK提供的专有编译器)。
附带说明一下,PC 市场的典型 Radeon 卡使用 AGP 或 PCI-e 总线接口。 好吧,Wii U 硬件仍然使用将 I/O 寄存器公开为内存位置的老式做法 。 我猜任天堂和 AMD 都不担心,因为这都是定制设计的一部分。
现在让我们一步一步地检查管线。 由于该设计与Xbox 360的Xenos GPU非常相似,我将尽量专注于GPU7的新颖之处,以避免重复信息。
指令
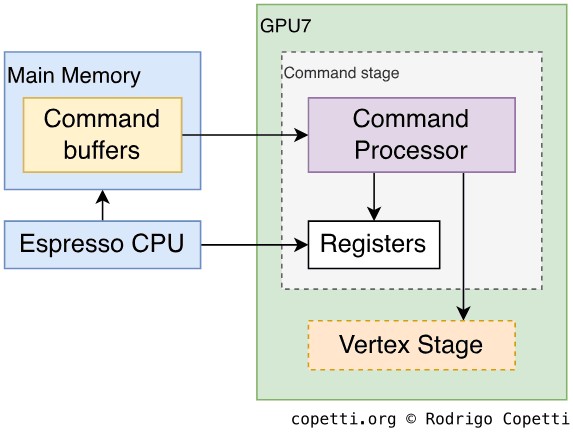
命令阶段概述.
对于大多数显卡,尤其是 ATI/AMD 显卡,起点始终是 指令处理器 正如我们之前多次看到的,这是GPU和外部世界 (即CPU)之间的门。
对于 GPU7,指令处理器读取存储在 RAM 中的指令并激活芯片内必要的引擎。 最值得注意的是,GPU7具有一个专用的直接内存访问(DMA) 控制器,可以在MEM1和MEM2之间操作数据,而无需CPU的干预。
此外,DMA可能会异步工作 (与其他电路不同步),因此GPU7提供了一些命令来刷新其缓存并与DMA同步 (以信号的形式) 以维持秩序。
Vertex
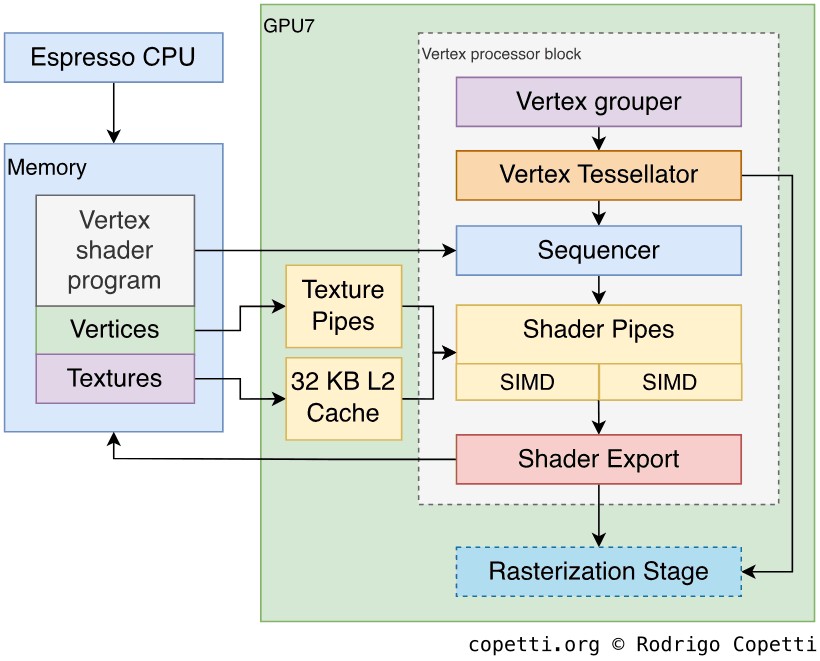
顶点 (vertex) 阶段概述. 你很快会发现,这个阶段和像素阶段也没有 那样地 不同.
乍一看,这个阶段与Xenos/Crayola基本一致,只是有些区块被扩大了 (增加了缓存),而有些区块则被收缩了(减少了ALU单元的数量,内存输出路径更短). 然而,这并不一定意味着性能下降,因为我们不要忘记GPU7比Xenos领先7年。
首先,让我们看看ALU(arithmetic-logic unit 算术逻辑单元是中央处理单元的一部分,它对计算机指令字中的操作数进行算术和逻辑运算。)。 Xenos依靠三根着色器管道(16个AUL区块)来执行vertex shaders(一种图形处理功能,用于通过对物体的顶点数据执行数学运算来为3D 环境中的物体添加特殊效果)。 GPU7仅捆绑两个16ALU的区块,但每个区块现在都被包围在一个更大的硬件叫做 SIMD 处理器, 我认为这一部分更大的附加电路(指 L1 缓存中的8KB和额外的接口和控制单元)是为了保持更多的并行流量。 此外,每个ALU都是由四个"子ALU"组成的,允许前者一次性计算由四个标量组成的向量。 ATI/AMD把这些子ALU叫做stream processors(流处理器),这是一个通用的营销术语。
现在,序列发生器(Sequencer)不会立刻发送计算结果,当计算结果到来时,他们首先会被合并成更大的一组64个顶点(vertices)以及一些元数据来控制操作, 这叫做 "波前"或"波导面"(Wavefront) 合并的Vertex组接着被发送到两个SIMD。考虑到在GPU7中只有32个ALU的事实。 这会花费 四个周期 来计算。
我认为这种新设计使制造商能够设计不同性能范围的显卡,通过 昂贵的设备包括更多的SIMD单元(如此只需要更少的时钟周期就能完成计算)。 作为一个不靠使用高端硬件而出名的游戏主机(他们通过能效来弥补),wiiu完成Wavefront的计算需要四个时钟周期
几何
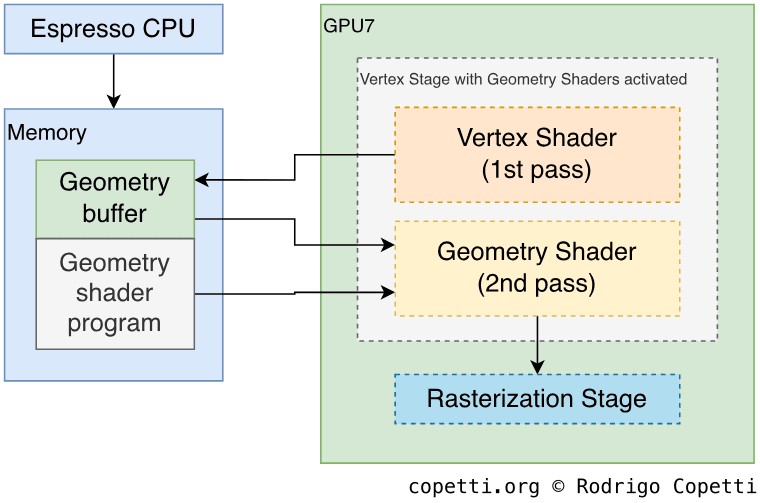
几何 (geometry) 阶段概述.
几何着色渲染器是在两个著名API(Direct3D和OpenGL)将同一规范的构造器纳入其规格之后出现的图形管道的新阶段。 这个新阶段的目的是使开发人员能够操纵基本元素(点、线或三角形),而不是单个顶点。 这对从现有几何图形程序化生成 新的几何图形很有帮助(即设计阴影、毛皮(fur)等等)。 GPU7像Radeon R700一样,继承了对 OpenGL 3.3 的遵守,因此支持这种新的着色器类型。
然而,在场景背后,几何阶段只是顶点阶段(vertex stage)的另一个"模式"。 为了让这一过程更加快速,如果几何着色器被激活,则顶点阶段(vertex stage)不会马上向前转发数据以进行光栅化。 相反,输出数据被保存在MEM2专用缓冲区中,顶点阶段(vertex stage)将会重新开始,但数据是从几何缓存区获取的。 然后波前(Wavefront)被组装用来收集多达64个"基元"或"图元"数据(primitive) 的索引,同时表示几何着色器的元数据将被执行。 随后,序列发生器(Sequencer)读取新的波前,解析原始数据并将其发送给两个SIMD以供计算。 这一过程将一直重复直到所有原始材料都得到处理为止。
最后,着色器管道进入光栅化阶段。
光栅器
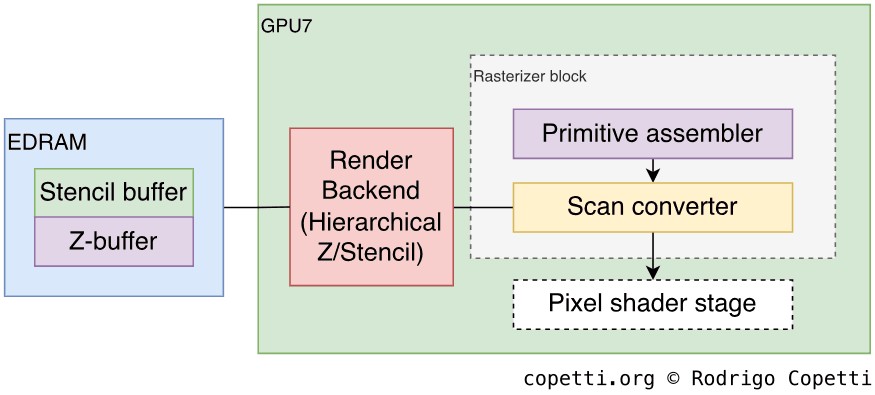
光栅阶段概述.
光栅化阶段往往比其他的阶段简单得多 主要原因是将顶点转换为像素的行为大多是系统性的,不需要额外的编程能力(除了一些可供调整的参数)。 因此,这个阶段与Crayola/Xenos是相同的。
虽然如此,Z缓冲区和模板缓冲区不再分配在专用内存上。 相反,新的渲染后端块(执行Z和模板测试,并支持分层测试) 必须访问RAM才能工作(EDRAM或主RAM)。
光栅化器可以使用128位像素格式 合成高达8192 x 8192像素的帧。 这将允许具有HDR色彩质量的大帧数。 然而,出于显而易见的原因,开发者并不需要_那么_大的帧数(1280 x 720对于这个控制台已经足够了),除了HDR将被广泛使用。
像素
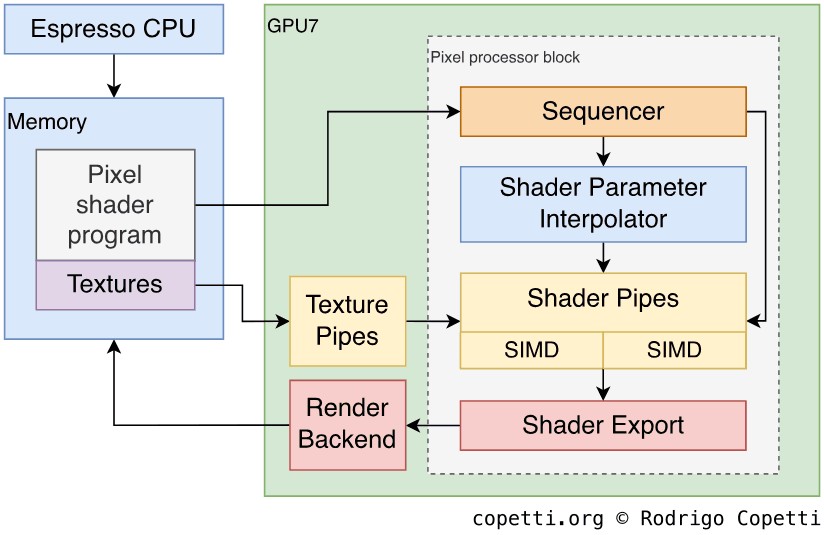
像素和分散阴影阶段概述.
像素着色器阶段采用与顶点着色器(vertex shader)相同的方法,除了现在已经被打乱的像素。 在经过了对Xenos像素功能和GPU7新的顶点管线的介绍之后,我担心这里没有太多可以解释的了。
现在负责将纹理提取到SIMD单元的块被称为纹理管道,并且有两个这样的管道。 每个纹理管道都包含8 KB的L1缓存,在访问RAM时它们共享32 KB的L2缓存。 此外,它们可以立即执行高达16倍的各向异性过滤,并且还可以获取立方体贴图(用于环境映射/反射)。
我想值得指出的是,着色器模型(OpenGL GLSL 3.3)为操作纹理添加了大量新例程(例如新类型的纹理混合,按位运算符,纹理调整)并消除了许多限制(例如每个着色器允许的指令数量)。 所有这些都使开发人员的工作变得更加容易。
像素操作
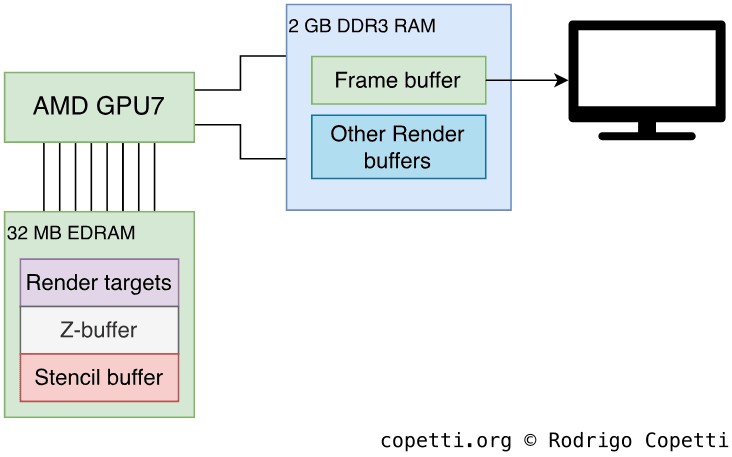
可用的像素操作概述.
一旦帧被渲染出来,开发人员可以应用更多的Z测试(如果在之前的阶段没有激活),颜色混合,并最终将像素导出到帧缓冲区以进行显示。 这都是由渲染后端(有两个) 执行的操作,它们位于像素着色器阶段的末尾。
最后,尽管Wii U没有像Xbox 360那样在EDRAM模块中捆绑复杂的电路,但GPU7仍然提供了许多有趣的功能。 这些功能包括 高达16次的自动多样本抗锯齿(MSAA 16x),用于软化边缘,令人惊讶的是,它不需要平铺渲染,因为Wii U拥有更大的32 MB EDRAM(MEM1),足以支持这些操作(当然,MSAA 16x可能会消耗过多的MEM1,不过MSAA 8x仍然可以接受)。
除此之外,我们还需要考虑程序员可能决定实现的自定义算法。 这要归功于API的灵活性和大量可用的着色器操作,包括Compute Shaders(将CPU计算卸载到GPU)。
交互式比较
我在交互式查看器上添加了新的 3D 模型,因此您可以自己检查之前(Hollywood GPU) 和之后(Latte GPU/GPU7) 的"效果":


"现代版本"中可用的互动模型
Wii 平台的超级马里奥银河 (2007) .
4,877个多边形.


"现代版本"中可用的互动模型
Wii U 平台的超级马里奥 3D 世界 (2013) .
9,304 个多边形.
虽然马里奥的纹理在Wii U上似乎没有提供很多额外的东西,但GPU7的改进在于额外的表面和骨骼,特别是手和脸,这使得模型对环境效果和动画的反应更加真实。 这样一来,在整个游戏过程中,场景看起来更加自然。
视频解码
除了GPU7的3D渲染能力之外,还有一个额外的功能是加入了H.264解码电路,将H.264压缩数据流转换为GPU可以理解的原始帧(并随后在屏幕上渲染). 主要优点是带宽效率没有性能损失。
因此,H.264单元可以以开发人员喜欢的任何方式 (即在游戏中或以电影的形式)用于在游戏中显示.
视频输出
现在是时候让任天堂放弃他们专有的模拟电路,拥抱(至少一个!) 视频标准了。 看,HDMI 1.4插孔终于被安装在了机器背面,同时还有传统的AV Multi Out作为 "备用"。

主机的后视图,有两个视频接口(HDMI 和 Multi-AV).
现在,尽管输出分辨率可最高达到 1080p, 但大多数游戏都使用 720p 来保证游戏表现和抗锯齿以及更高的分辨率之间的平衡。 使用 720p 还有助于开发人员在不改变游戏逻辑的情况下保持对 480i 和 576i 的支持(因为视频编码器负责自动缩小帧). 这种操作方式与PlayStation 3和Xbox 360的操作方式一致。
辅助GPU
话说回来,这台主机为什么还能玩Wii游戏? 是否有某种GPU7到 Hollywood的模拟器在幕后运行? 嗯,简短的回答是不。 你可能会感到惊讶,任天堂直接在 Latte 中添加了Hollywood的旧GPU电路(我们称之为"Wii GPU") 。 这个单元只在Wii游戏运行时起作用。 虽然,Wii GPU 装有旧的 3 MB 的 1T-SRAM,也就是我们现在所知的 MEM0。 因此,至少新硬件使用了额外的内存。
此外,任天堂还安装了一个名为DMCU的额外芯片,以复制旧的视频接口。 根据 fail0verflow的信息,DMCU 只是一个摩托罗拉 68HC11 控制器,它被编程为像前身一样工作。 它的唯一目的是接收来自Wii游戏的指令,并将帧转发给GPU7,以便后者能够将其在电视上播放。 由于Wii游戏是为PAL/NTSC显示制作的,GPU7的视频编码器必须使其升频(根据我的经验,它并不擅长这样做......)。
如果你想知道,Wii U游戏有没有'Wii GPU和GPU7'协同处理的功能。 尽管我们知道其中一方会给另一方造成瓶颈,但它将会是十分有趣的事情......